
This thread has been locked.

If you have a related question, please click the "Ask a related question" button in the top right corner. The newly created question will be automatically linked to this question.

[参考译文] AM263P4:AM263P4 的高速缓存一致性和数据对齐问题

Guru**** 2943350 points
请注意,本文内容源自机器翻译,可能存在语法或其它翻译错误,仅供参考。如需获取准确内容,请参阅链接中的英语原文或自行翻译。

https://e2e.ti.com/support/microcontrollers/arm-based-microcontrollers-group/arm-based-microcontrollers/f/arm-based-microcontrollers-forum/1643394/am263p4-cache-coherence-and-data-alignment-issues-for-am263p4

器件型号: AM263P4

`` tifs_am263px_11_00_00_01 μ s 示例的分析、当主内核和 HSM 内核请求 TRNG 服务时、必须在将数据发送到 HSM 内核之前和将数据接收回主内核之后执行高速缓存一致性管理、如下所示。 `get_cache_aligned_size`宏会将要缓存管理的数据大小对齐到 128 字节的倍数(用于缓冲区对齐的缓存行大小)。

*问题 1:**  
定义数据时是否有必要强制对齐、例如`HsmClient_t CLIENT __attribute__(aligned (aligned (Mcal_Cache P_CACHELINE_ALIGNAL))`? 或者仅在`CacheP_wbInv`、`CacheP_WB`和`CacheP_Inv`中执行对齐是否足够? 据我了解、TI 的流程只执行后者。 忽略前者会产生什么影响?
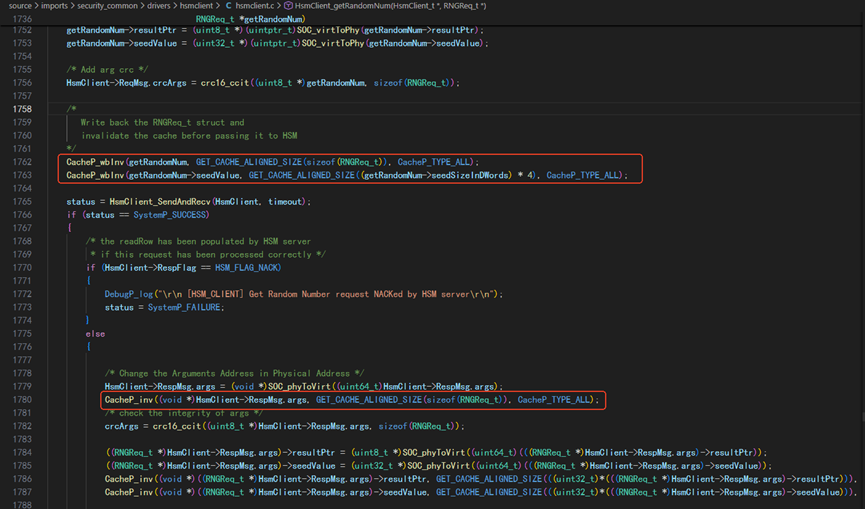
image.png

*问题 2:**  
仅当多个内核 (R5SS0_CORE0、R5SS0_CORE1、R5SS1_CORE0、R5SS1_CORE0、R5SS1_CORE0、R5SS1_CORE0、R5SS1_CORE1、Mcal_Cache R5SS1_CORE1、HSM) 使用数据时、才需要上述数据对齐(例如:HsmClient_t CLIENT__)) 和高速缓存一致性管理?  
如果数据仅在 R5SS0_CORE0 中使用或放置在不可缓存的区域中、那么上述操作是否不必要?

  • 请注意,本文内容源自机器翻译,可能存在语法或其它翻译错误,仅供参考。如需获取准确内容,请参阅链接中的英语原文或自行翻译。

    您好、

    **问题 1:**  
    定义数据时是否有必要强制对齐、例如`HsmClient_t CLIENT __attribute__(aligned (aligned (Mcal_Cache P_CACHELINE_ALIGNAL))`? 或者仅在`CacheP_wbInv`、`CacheP_WB`和`CacheP_Inv`中执行对齐是否足够? 据我了解、TI 的流程只执行后者。 忽略前者会有什么影响?

    在需要对变量进行缓存对齐方面没有限制。 要求每当从多核访问缓存区域时、就需要执行缓存维护操作、例如 CacheP_wbInv、CacheP_WB 和 CacheP_Inv、这应该在缓存对齐的内存上完成。

    上述数据对齐(例如,H.HsmClient_t client __attribute__(aligned (SS0_P_CACHELINE_ALIZATION))) 和高速缓存一致性管理仅在多个内核 (R5SS1_CORE0、R5SS0_CORE1、Mcal_Cache CORE1、R5SS1_CORE1) 存储器中使用数据时才需要?  
    如果数据仅在 R5SS0_CORE0 中使用或放置在不可缓存的区域中、那么上述操作是否不必要?
    如果内核本身正在访问数据、并且没有其他内核修改相同数据、则不需要执行缓存维护操作。 如果区域未缓存、也不需要执行此操作。

    谢谢。此致、

    Nikhil Dasan  

  • 请注意,本文内容源自机器翻译,可能存在语法或其它翻译错误,仅供参考。如需获取准确内容,请参阅链接中的英语原文或自行翻译。

    问题 1:
    您是否意味着我不需要在定义时执行对齐(例如,HsmClient_t client __attribute__(aligned (Mcal_Cache CacheP_CACHELINE_alignment)))、但只需要传递通过 get_cache_aligned_size 对齐的大小、作为调用 CacheP_wbInv、CacheP_WB 和 CacheP_Inv 时的第二个参数?

    问题 2:
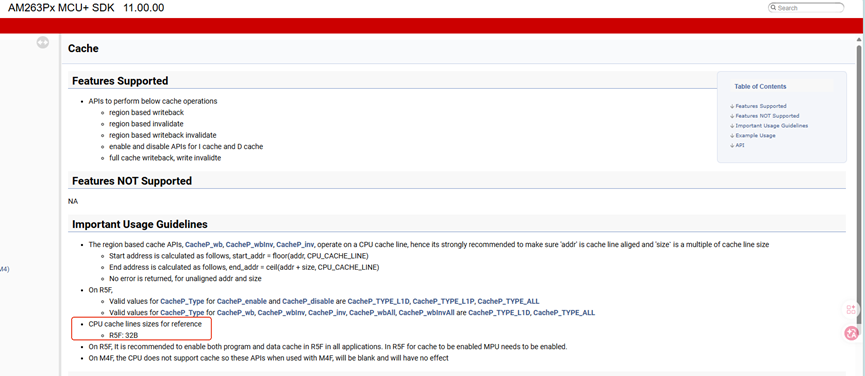
    为什么 Mcal_Cache 工程中的 MCAL P_CACHELINE_ALIGNATION 设置为 128B? 它是为了保持不同平台之间的一致性吗? 因为我看到 R5F 的高速缓存线为 32B。

    问题 3:
    #define GET_CACHE_ALIGNED_SIZE (x) 使用上述宏、计算出的大小是大于或等于 x 的 128B 的最小倍数。例如、如果 x 为 128B、则实际对齐区域变为 256B。 这是为了防止影响边界上的其他数据吗?

  • 请注意,本文内容源自机器翻译,可能存在语法或其它翻译错误,仅供参考。如需获取准确内容,请参阅链接中的英语原文或自行翻译。

    您好、

    很抱歉耽误响应。 我在内部与多位专家进行了详细讨论、我认为这是当前固件中的一个错误。

    问题 1:
    您是否意味着我不需要在定义时执行对齐(例如,HsmClient_t client __attribute__(aligned (CacheP_CACHELINE_alignment)))、但只需要传递通过 get_cache_aligned_size 对齐的大小、作为调用 CacheP_wbInv、Mcal_Cache 和 CacheP_Inv]时的第二个参数?

    避免影响、结构应在定义时在此处对齐。 我已经在内部提交了一个错误,以解决这个在我们的最后通过做一个重建.
    同时、如果可行、您可以将此区域视为可共享区域、以避免缓存维护影响。

    问题 2:
    为什么 Mcal_Cache 工程中的 MCAL P_CACHELINE_ALIGNATION 设置为 128B? 它是为了保持不同平台之间的一致性吗? 因为我看到 R5F 的高速缓存行为 32B。

    这是从其他平台导入的。 但这应该是 32B。 我在内部提出了一个错误来解决这个问题。

    ]问题 3:
    #define GET_CACHE_ALIGNED_SIZE (x) 使用上述宏、计算出的大小是大于或等于 x 的 128B 的最小倍数。例如、如果 x 为 128B、则实际对齐区域变为 256B。 这是为了防止影响边界上的其他数据吗?

    是的、这不应设置为 256B。 它应与缓存行大小本身对齐。  我在内部提出了一个错误来解决这个问题。

    感谢您分享这些观察结果。 我们将在即将发布的版本中修复此问题。

    谢谢。此致、

    Nikhil Dasan

    [/quote]