This thread has been locked.

If you have a related question, please click the "Ask a related question" button in the top right corner. The newly created question will be automatically linked to this question.

[参考译文] AM2434:EtherCAT PRU 读取/写入时间

Guru**** 3003130 points

Other Parts Discussed in Thread: AM2434

请注意,本文内容源自机器翻译,可能存在语法或其它翻译错误,仅供参考。如需获取准确内容,请参阅链接中的英语原文或自行翻译。

https://e2e.ti.com/support/microcontrollers/arm-based-microcontrollers-group/arm-based-microcontrollers/f/arm-based-microcontrollers-forum/1648375/am2434-ethercat-pru-read-write-time

器件型号: AM2434

尊敬的 TI 专家:


我们正在评估 AM2434 上的 EtherCAT 周期时间是否可以为 50us。 因此、我们需要测量函数 HW_EscReadIsr 和 HW_EscWriteIsr 的运行时。

令人惊讶的是、当 RPDO 大小为 9 个字节时、HW_EscReadIsr 需要 4us;当 RPDO 大小为 19 个字节时、需要 5.5us。

我想知道我们的测量是否正确。 我 在 https://e2e.ti.com/support/microcontrollers/arm-based-microcontrollers-group/arm-based-microcontrollers/f/arm-based-microcontrollers-forum/1287056/am2432-what-s-the-bandwidth-of-the-shared-ocram 中看到 OCRAM 速度为 64b @ 250MHz。

但 19 字节和 9 字节之间的时间增量为 1.5us、这意味着每字节 0.15us。

因此、如果运行时间有效并且无法减少、共享存储器之间的读取/写入时间是多少? 我们还需要知道、EtherCAT 使用单独的内核、电机控制使用单独的内核是否可行。

谢谢、

建宇

  • 请注意,本文内容源自机器翻译,可能存在语法或其它翻译错误,仅供参考。如需获取准确内容,请参阅链接中的英语原文或自行翻译。

    通过互连对 ICSSG SMEM 进行逐字节 R5F 访问时、每字节 150ns 延迟是预期行为。 以下是评估和建议的前进道路:

    对于 19 字节过程数据、 从字节复制切换到 32 位字复制 是正确的立即优化方法。 这将总线事务数量从 19 个减少到 5 个(4 个字读取+余数为 1 个字节)、使您每 32 位字~150ns、而不是每字节[1]。 ICSSG 内部 SMEM (64KB) 相对于内部 PRU 内核的访问延迟为~15ns、但 R5F 访问会遍历外部互连、这增加了您看到的延迟

  • 请注意,本文内容源自机器翻译,可能存在语法或其它翻译错误,仅供参考。如需获取准确内容,请参阅链接中的英语原文或自行翻译。

    OK、、因此这适用于所有 DPRAM 读取/写入、SDO 和 PDO。 还是 ESC 寄存器?

  • 请注意,本文内容源自机器翻译,可能存在语法或其它翻译错误,仅供参考。如需获取准确内容,请参阅链接中的英语原文或自行翻译。

    以上说明主要适用于 SDO、PDO 和 DPRAM 读取/写入。 由于 ESC 寄存器也通过 ICSS SMEM 进行仿真、这在技术上是适用的、但您是否看到堆栈中频繁地循环访问 ESC 寄存器(每次访问 8 位)?

  • 请注意,本文内容源自机器翻译,可能存在语法或其它翻译错误,仅供参考。如需获取准确内容,请参阅链接中的英语原文或自行翻译。

    您好 Pratheesh、

    PDO 的起始地址似乎没有 4 字节对齐。 如果我直接使用如下代码所示的 4 字节副本、驱动器就会崩溃。

    while (c>=4)
    {
    *(uint32_t *) d =*(uint32_t *) s;
    D+=4;
    S+=4;
    C-=4;
    }代码

    我绘制了&PESC[0x1100]的地址、假定 SM2 地址每个周期都会更改。

    然后、在我开始添加 4 字节对齐后、我无法观察到运行时间有任何改善。

    在测试 19 字节 RPDO 时、我们确实可以实现大约 500ns 的改进。 运行时间减少到大约 5uS。

    我不知道是否还有其他的改善。 当前测试将用 bsp_myread 替换 bsp_read。

  • 请注意,本文内容源自机器翻译,可能存在语法或其它翻译错误,仅供参考。如需获取准确内容,请参阅链接中的英语原文或自行翻译。

    e2e.ti.com/.../bsp_5F00_myread.c

    附加了电流功能。

  • 请注意,本文内容源自机器翻译,可能存在语法或其它翻译错误,仅供参考。如需获取准确内容,请参阅链接中的英语原文或自行翻译。

    主要是 ESC 寄存器 0x220 AL 事件。 它在 1ms 内处理、如果需要更长的时间、则没关系。

    但您是否看到堆栈中频繁地循环访问 ESC 寄存器(每次访问 8 位)?
  • 请注意,本文内容源自机器翻译,可能存在语法或其它翻译错误,仅供参考。如需获取准确内容,请参阅链接中的英语原文或自行翻译。
    在测试 19 字节 RPDO 时、我们确实提高了大约 500ns。 运行时间减少到大约 5uS。

    使用的优化级别是什么? 您能了解一下反汇编级别的 增量吗

    [引述 userid=“622144“ url=“~/support/microcontrollers/arm-based-microcontrollers-group/arm-based-microcontrollers/f/arm-based-microcontrollers-forum/1648375/am2434-ethercat-pru-read-write-time/6358208
    我想知道是否可以有更多的改进。

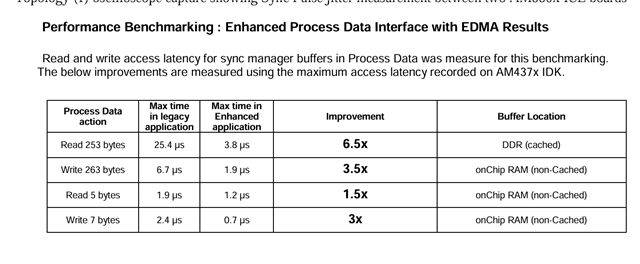
    可能会有一些可能、例如将 PRU DMA 添加到 R5F TCM、但这需要修改固件以及可能的堆栈接口更改(我们通过 EDMA 在 AM437x EtherCAT 实现上做了类似的操作)、但到目前为止、这不是 AM64/AM243 上的计划特性

    https://dr-download.ti.com/software-development/driver-or-library/MD-JLNx46uE7Y/01.00.10.00/EtherCAT_Slave_Datasheet.pdf 

  • 请注意,本文内容源自机器翻译,可能存在语法或其它翻译错误,仅供参考。如需获取准确内容,请参阅链接中的英语原文或自行翻译。

    我们的优化级别最多为 OIptimize (o3)、汇编代码如下。

    70122234 <bsp_myread>:
    70122234: e52db004       str  r11, [sp, #-4]!
    70122238: e28db000       add  r11, sp, #0
    7012223c: e24dd02c       sub  sp, sp, #44
    70122240: e50b0020       str  r0, [r11, #-32]
    70122244: e50b1024       str  r1, [r11, #-36]
    70122248: e1a01002       mov  r1, r2
    7012224c: e1a02003       mov  r2, r3
    70122250: e1a03001       mov  r3, r1
    70122254: e14b32b6       strh  r3, [r11, #-38]
    70122258: e1a03002       mov  r3, r2
    7012225c: e14b32b8       strh  r3, [r11, #-40]
    70122260: e51b3020       ldr  r3, [r11, #-32]
    70122264: e5933004       ldr  r3, [r3, #4]
    70122268: e5933004       ldr  r3, [r3, #4]
    7012226c: e2833801       add  r3, r3, #65536
    70122270: e50b3018       str  r3, [r11, #-24]
    70122274: e51b3024       ldr  r3, [r11, #-36]
    70122278: e50b3008       str  r3, [r11, #-8]
    7012227c: e15b32b6       ldrh  r3, [r11, #-38]
    70122280: e51b2018       ldr  r2, [r11, #-24]
    70122284: e0823003       add  r3, r2, r3
    70122288: e50b300c       str  r3, [r11, #-12]
    7012228c: e15b32b8       ldrh  r3, [r11, #-40]
    70122290: e50b3010       str  r3, [r11, #-16]
    70122294: e51b300c       ldr  r3, [r11, #-12]
    70122298: e2033003       and  r3, r3, #3
    7012229c: e2633004       rsb  r3, r3, #4
    701222a0: e50b3014       str  r3, [r11, #-20]
    701222a4: e51b3014       ldr  r3, [r11, #-20]
    701222a8: e3530000       cmp  r3, #0
    701222ac: 0a000026       beq  0x7012234c <bsp_myread+0x118> @ imm = #152
    701222b0: e51b2010       ldr  r2, [r11, #-16]
    701222b4: e51b3014       ldr  r3, [r11, #-20]
    701222b8: e1520003       cmp  r2, r3
    701222bc: ba000022       blt  0x7012234c <bsp_myread+0x118> @ imm = #136
    701222c0: ea00000c       b  0x701222f8 <bsp_myread+0xc4> @ imm = #48
    701222c4: e51b300c       ldr  r3, [r11, #-12]
    701222c8: e5d32000       ldrb  r2, [r3]
    701222cc: e51b3008       ldr  r3, [r11, #-8]
    701222d0: e5c32000       strb  r2, [r3]
    701222d4: e51b3008       ldr  r3, [r11, #-8]
    701222d8: e2833001       add  r3, r3, #1
    701222dc: e50b3008       str  r3, [r11, #-8]
    701222e0: e51b300c       ldr  r3, [r11, #-12]
    701222e4: e2833001       add  r3, r3, #1
    701222e8: e50b300c       str  r3, [r11, #-12]
    701222ec: e51b3014       ldr  r3, [r11, #-20]
    701222f0: e2433001       sub  r3, r3, #1
    701222f4: e50b3014       str  r3, [r11, #-20]
    701222f8: e51b3014       ldr  r3, [r11, #-20]
    701222fc: e3530000       cmp  r3, #0
    70122300: 1affffef       bne  0x701222c4 <bsp_myread+0x90> @ imm = #-68
    70122304: e51b2010       ldr  r2, [r11, #-16]
    70122308: e51b3014       ldr  r3, [r11, #-20]
    7012230c: e0423003       sub  r3, r2, r3
    70122310: e50b3010       str  r3, [r11, #-16]
    70122314: ea00000c       b  0x7012234c <bsp_myread+0x118> @ imm = #48
    70122318: e51b300c       ldr  r3, [r11, #-12]
    7012231c: e5932000       ldr  r2, [r3]
    70122320: e51b3008       ldr  r3, [r11, #-8]
    70122324: e5832000       str  r2, [r3]
    70122328: e51b3008       ldr  r3, [r11, #-8]
    7012232c: e2833004       add  r3, r3, #4
    70122330: e50b3008       str  r3, [r11, #-8]
    70122334: e51b300c       ldr  r3, [r11, #-12]
    70122338: e2833004       add  r3, r3, #4
    7012233c: e50b300c       str  r3, [r11, #-12]
    70122340: e51b3010       ldr  r3, [r11, #-16]
    70122344: e2433004       sub  r3, r3, #4
    70122348: e50b3010       str  r3, [r11, #-16]
    7012234c: e51b3010       ldr  r3, [r11, #-16]
    70122350: e3530003       cmp  r3, #3
    70122354: caffffef       bgt  0x70122318 <bsp_myread+0xe4> @ imm = #-68
    70122358: ea00000c       b  0x70122390 <bsp_myread+0x15c> @ imm = #48
    7012235c: e51b300c       ldr  r3, [r11, #-12]
    70122360: e5d32000       ldrb  r2, [r3]
    70122364: e51b3008       ldr  r3, [r11, #-8]
    70122368: e5c32000       strb  r2, [r3]
    7012236c: e51b3008       ldr  r3, [r11, #-8]
    70122370: e2833001       add  r3, r3, #1
    70122374: e50b3008       str  r3, [r11, #-8]
    70122378: e51b300c       ldr  r3, [r11, #-12]
    7012237c: e2833001       add  r3, r3, #1
    70122380: e50b300c       str  r3, [r11, #-12]
    70122384: e51b3010       ldr  r3, [r11, #-16]
    70122388: e2433001       sub  r3, r3, #1
    7012238c: e50b3010       str  r3, [r11, #-16]
    70122390: e51b3010       ldr  r3, [r11, #-16]
    70122394: e3530000       cmp  r3, #0
    70122398: 1affffef       bne  0x7012235c <bsp_myread+0x128> @ imm = #-68
    7012239c: e320f000       nop
    701223a0: e320f000       nop
    701223a4: e28bd000       add  sp, r11, #0
    701223a8: e49db004       ldr  r11, [sp], #4
    701223ac: e12fff1e       bx  lr

  • 请注意,本文内容源自机器翻译,可能存在语法或其它翻译错误,仅供参考。如需获取准确内容,请参阅链接中的英语原文或自行翻译。

    您好 Pratheesh、

    由于 AM24 目前不支持 EDMA、因此请帮助了解是否可以对客户上面提供的汇编代码(对于函数 bsp_myread.c)进行任何进一步优化、谢谢。

    同时、客户将分析当前配置设置是否能够满足其应用级目标。 如果不是、也没有其他优化可以尝试、那么我们稍后会在支持中讨论 AM24 上的 EDMA 移植。

    谢谢、

    Kevin

  • 请注意,本文内容源自机器翻译,可能存在语法或其它翻译错误,仅供参考。如需获取准确内容,请参阅链接中的英语原文或自行翻译。
    我们的优化级别最多为 OIptimize (o3)、汇编代码如下。

    我们对汇编片段进行了一些分析  

    关键问题:每次循环迭代中的栈溢出过多

    最严重的问题是 所有循环变量 (src PTR、dst PTR、count、alignment) 都存储在堆栈中、并在每次迭代时重新加载、 而不是保存在寄存器中。
    字复制循环 (0x70122318–0x70122348)-每 4 个字节 13 条指令:
    ldr r3,[r11,#–12];从堆栈重新加载 src ptr
    LDR R2、[R3];实际负载
    ldr r3,[r11,#–8];从堆栈重新加载 dstt ptr
    STR R2、[R3];实际存储
    ldr r3,[r11,#–8];再次重新加载 dst PTR
    添加 R3、R3、#4
    str r3、[r11、#–8];将 dst ptr 写回堆栈
    ldr r3,[r11,#–12];再次重新加载 src PTR
    添加 R3、R3、#4
    str r3、[r11、#–12];将 src ptr 写回堆栈
    ldr r3,[r11,#–16]; reload count
    SUB R3、R3、#4
    str r3、[r11、#–16];将计数写回堆栈
    这 13 个说明中只有 2 个确实有效。 其余是冗余栈流量。

    SDK  memcpy ():
    ;内部循环:2 条指令中 16 个字节、指针停留在寄存器中
    LDM R1 !,{r3, r4, r12, r14}; 加载 4 个字、自动递增 R1
    stm r0!,{r3, r4, r12, r14}; 存储 4 个字、自动递增 r0
    SUB R2、R2、#0x10;递减计数
    bs #loop;分支 if≥0
    SDK memcpy 在~3 条指令中复制 16 个字节。 ~的代码需要 4 个字节的 × 13 条指令—大约需要 10 μ s 指令开销。

    1.可以尝试使用__restrict 进行操作、以提示 src DST/DST 参数不是别名
    void bsp_myread(void *___restrictdst、 const void *___restrictsrc、 uint16_t addr、uint16_t len);
    2.使用指针的本地寄存器副本:
    uint8_t *d =(uint8_t *) dst;
    const uint8_t * s =(const uint8_t *) src + addr;
    //编译器现在可以将 d 和 s 保留在寄存器中
    3. 将字复制循环替换为 LDM/STM(或仅使用 memcpy (__builtin_memcpy))
    //对齐处理后:
    uint32_t words =剩余>> 2;
    if (words){
    memcpy (d、s、words << 2);// SDK memcpy 在内部使用 LDM/STM
    d +=字<< 2;
    S +=字<< 2;
    剩余&= 3;
    }
    //字节尾
    当(剩余--)*d++=*s++时;

    大得多 余弦值 优化(估算)
    4 字节对齐的复制 ~13 个实例/字 ~3 个实例/16 字节 (LDM/STM)
    19 字节 RPDO(大约 5 个字) ~65 条以上的说明 ~10–15 说明
    预期的运行时改进 ~5µs baseline 可额外减少 1–1.5µs